|
人工智能的训练与推理,正在把数据中心从“机房”变成“电厂”。单机柜功率从几千瓦跃升至数十千瓦甚至更高,一个万卡集群的用电量足以抵得上一座中小型城镇。传统数据中心“按最大负荷设计、平时留足余量”的思路,在高密算力场景下逐渐失效——电供不进去,热出不来,交付周期赶不上业务上线速度。智算中心要解决的,已经不只是“算得快”,更是“电够用、热散得掉、建得起来”。
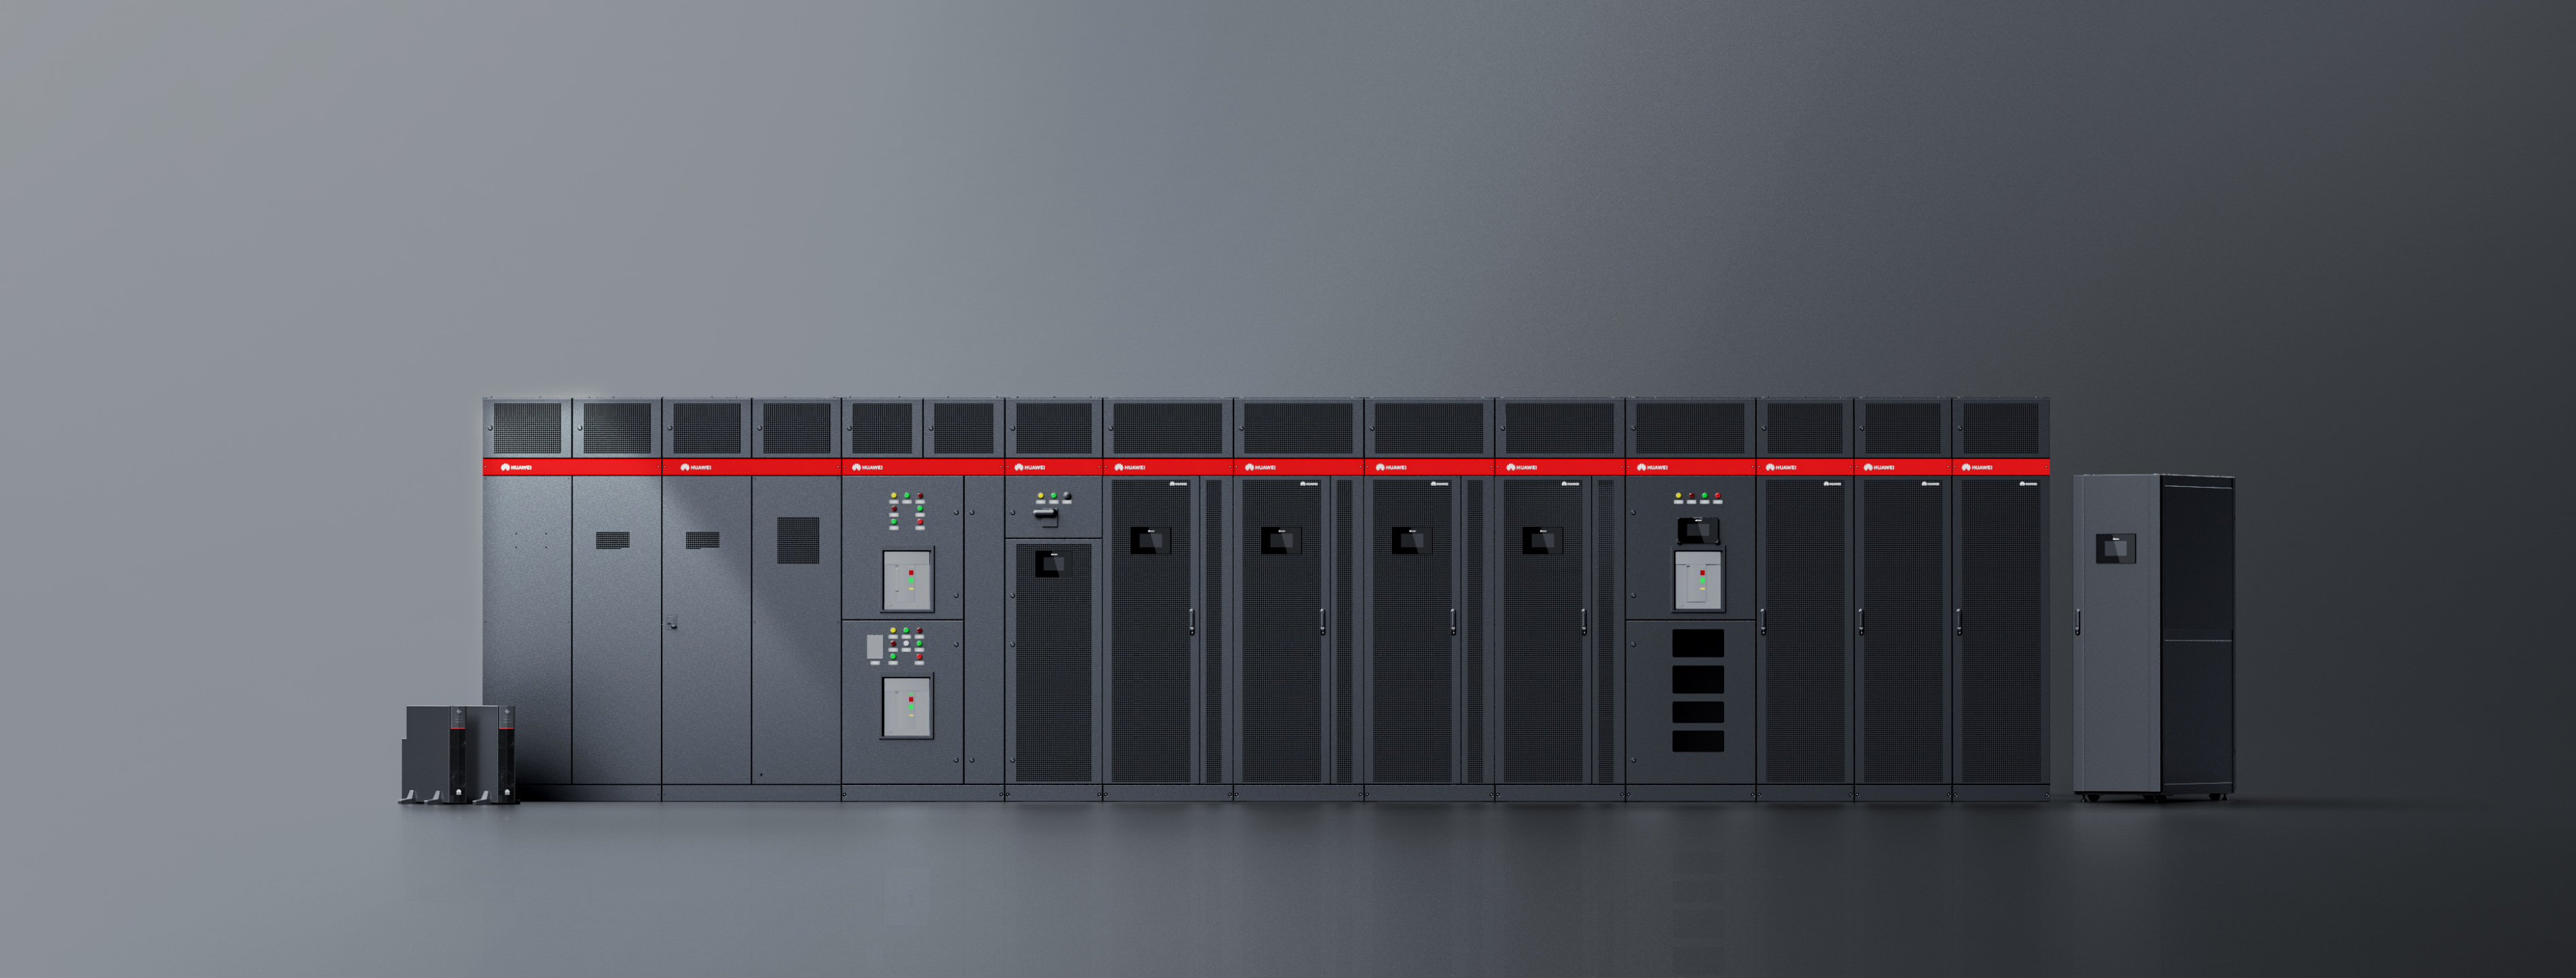
高密算力的两道坎:供电与散热 智算负载的特殊性在于脉冲式波动。一个大模型训练任务可能在数小时内让机柜功率拉满,任务结束后又迅速回落;推理服务则随业务潮汐起伏。这种波动对供配电系统提出苛刻要求:既要在峰值时稳定承载,又不能在低谷时过度配置。 散热是另一道坎。传统风冷方案在单柜功率超过一定阈值后效率急剧下降,液冷从“可选项”变成“必选项”。华为智算中心所围绕的基础设施方案,正是在这一背景下展开:从电网到芯片重构供电链路,从芯片到户外重构热管理链路,目标不是堆叠参数,而是让电进得去、热出得来。 供电链路:从“够用”到“可调” 智算中心的供电架构正在经历分化。中低密场景仍以交流UPS为主,高密智算则逐步向直流方案演进,但产业链成熟度和安全标准仍在完善中。相关方案中,电力模块通过架构融合实现省柜省地,以预制母排替代传统线缆,将供电链路的交付周期从数月压缩至数周。 储能在这个体系中的角色也在变化。从单纯的备电,转向多级储能协同,以应对AI负载突增突减对电网的冲击。对于园区级智算中心而言,储能可以在电价低谷时充电、高峰时释放,辅助平滑用电曲线,同时为关键负载提供缓冲。 热管理:液冷的关键不是“冷”,是“可控” 液冷系统涉及冷却液分配、热交换、管路密封和泄漏检测等多个环节。单点制冷能力再强,若系统级协同跟不上,可靠性就无从谈起。相关方案中,液冷热管理控制器TMU被定位为液冷系统的“中枢”,承担从冷源到末端的调度与监控。其采用双AC/DC供电架构,主备电切换时间控制在毫秒级,避免因控制器失电导致服务器温升。 对于已建成或在建的风冷机房,风液融合是更现实的路径。制冷系统需要兼容不同风冷、液冷方案,支持平滑演进,而不是要求用户推倒重来。 建设模式:把复杂度留在工厂 智算中心的交付速度直接影响算力上线时间。传统工程模式下,从设计到调试往往需要八到十二个月,而AI业务的市场窗口未必等得起。预制化、模块化的思路是将供配电、制冷、管路等系统在工厂完成预集成和测试,现场只做简单安装与调试,交付周期可压缩至三到六个月。 这种模式的价值不仅在于快。工厂环境下的质量控制比现场施工更稳定,减少因人为因素导致的隐患。对于需要快速扩容的智算集群,模块化设计也提供了按需扩展的弹性,不必一次性配满。 一个可参照的实践 青岛地铁的智算中心提供了一个规模适中的样本。该项目一期建设8台超节点(64卡),采用“小步快跑、按需扩容”的策略,降低了初始投入和机房改造门槛。训练与推理任务共享同一算力池,资源利用率提升约30%。在6号线的试点中,智能体应用减少了约70%的人工操作流程,故障处置效率提升70%以上。 这个案例的参考意义不在于规模,而在于路径:从实际业务需求出发,先跑通再扩容,而不是追求一步到位的“大而全”。对于多数企业而言,智算中心的建设节奏,应当与自身AI应用的成熟度匹配,而非被算力焦虑推着走。 规划之前需要想清楚的事 建设或改造智算中心前,有几个问题值得先回答:负载类型是什么——训练为主还是推理为主?功率密度预计达到多少?现有电网容量是否支撑?散热方案是全新设计还是利旧改造?这些问题决定了供电架构、制冷方式和储能配置的选择,而非简单参照其他项目的参数。 容量并非越大越好。供电和制冷系统过度配置会增加初始投入和运行能耗,配置不足则可能在高密负载上线后成为瓶颈。合理的方式是基于实际负载曲线和扩展预期进行测算,在冗余和成本之间找到平衡点。 智算中心的意义,不在于把设备堆得多先进,而在于让算力、电力和散热在同一套逻辑下协同运行。当每一瓦特电力都能更高效地转化为算力输出,智算基础设施才真正从“能耗大户”走向“效率工程”。
|
|
1
 鲜花 |
1
 握手 |
 雷人 |
 路过 |
 鸡蛋 |
业界动态|铂悦新闻网
2026-10-19
2026-10-19
2026-10-19
2026-10-18
2026-10-18




请发表评论